Приёмка GPU-сервера — это не только сверка коробок с накладной. За первые часы после включения нужно убедиться, что на месте все GPU нужной модели, память и диски исправны, связь между ускорителями работает на полной скорости, а в журнале BMC нет ошибок. Ниже — порядок проверки и что записать в акт приёмки.
Внешний осмотр и комплектация
Начинайте до вскрытия упаковки:
- целостность коробок, индикаторы удара и наклона, если они есть на упаковке;
- пломбы и заводские наклейки на корпусе;
- серийный номер шасси — против договора, накладной и отчёта о проверке перед отгрузкой;
- комплект: рельсы, кабели питания, блоки питания, заглушки, документация;
- корпус без вмятин, разъёмы и порты без повреждений.
Всё, что выглядит странно, фотографируйте сразу и до подписания документов о доставке.
Первое включение и журнал BMC
Сервер подключается к сети управления, и до загрузки ОС проверяется через BMC — веб-интерфейс или утилиту ipmitool.
- Датчики (ipmitool sdr): температуры, обороты вентиляторов, напряжения в норме.
- Блоки питания: все определяются, резервирование работает. Проверьте, что сервер остаётся включённым при отключении одного ввода.
- Журнал событий (ipmitool sel list): сохраните его сразу, до любых тестов. Ошибки памяти, PCIe или питания на новом сервере — повод разбираться до приёмки.
- Версии BIOS и BMC — запишите, они понадобятся при обращении в поддержку.
Число и модель GPU: nvidia-smi
После загрузки ОС и драйвера первым делом запускают nvidia-smi.
- nvidia-smi -L выводит список GPU с моделью и UUID. Их должно быть ровно столько, сколько в спецификации, и модель должна совпадать.
- nvidia-smi -q даёт подробности по каждому GPU: серийный номер, версию VBIOS, объём памяти, поколение и ширину шины PCIe. Сверьте серийные номера с отчётом о проверке перед отгрузкой.
- nvidia-smi -q -d ECC показывает ошибки памяти. На новом сервере некорректируемых ошибок быть не должно.
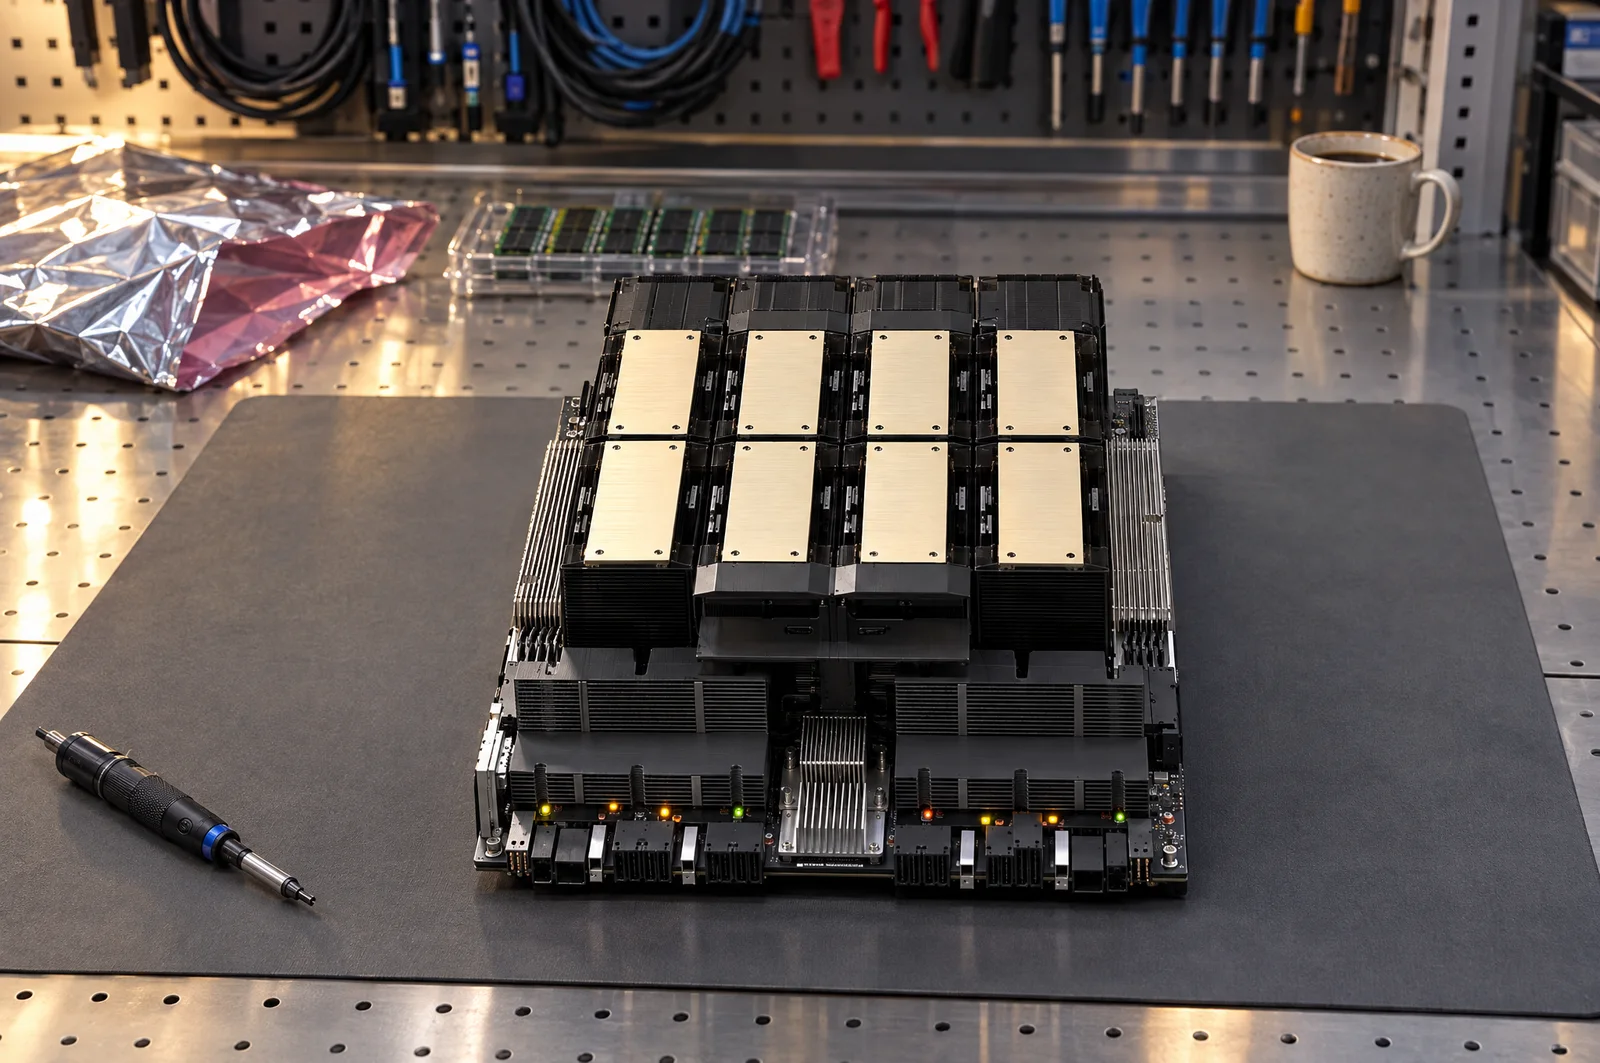
- nvidia-smi topo -m показывает топологию. На платформах HGX H200 и HGX B200 все пары GPU должны быть связаны через NVLink.
- nvidia-smi nvlink -s выводит состояние и скорость каждого линка NVLink. Неактивный линк — дефект.
На платах HGX с коммутаторами NVSwitch должна работать служба NVIDIA Fabric Manager (nvidia-fabricmanager). Без неё приложения не смогут использовать GPU, хотя nvidia-smi их видит.
Диагностика DCGM
NVIDIA DCGM (Data Center GPU Manager) — штатный инструмент диагностики серверных GPU. Команда dcgmi discovery -l показывает найденные GPU, а dcgmi diag запускает тесты разной глубины, от уровня 1 (секунды) до уровня 4 (самый долгий).
Для приёмки используйте уровень 3 или 4. Он проверяет драйвер и окружение, шину PCIe, память GPU и работу под нагрузкой на заданной мощности. Результат — PASS или FAIL по каждому тесту. Любой FAIL — повод не подписывать акт, пока причина не найдена.
Для AMD Instinct аналогичную роль играют утилиты amd-smi и rocm-smi и набор тестов ROCm Validation Suite.
Стресс-тест под полной нагрузкой
GPU-сервер работает на пиковой мощности часами, поэтому проверять его нужно так же.
- GPU: gpu_burn из открытого проекта gpu-burn нагружает все GPU и сверяет результаты вычислений. Время задаётся в секундах; для приёмки разумно несколько часов. Параллельно nvidia-smi dmon показывает мощность, температуру и частоты в реальном времени.
- Сброс частот: nvidia-smi -q -d PERFORMANCE показывает причины снижения частот. Тепловой троттлинг на новом сервере в нормальной стойке — признак проблемы с охлаждением.
- Ошибки драйвера: в выводе dmesg или journalctl -k не должно быть сообщений NVRM: Xid.
- Процессоры и память: stress-ng нагружает CPU и ОЗУ. Объём памяти проверяют через free -g, число и модель модулей — через dmidecode -t memory. Ошибки памяти собирает rasdaemon: команда ras-mc-ctl --errors не должна показывать ошибок.
Во время теста смотрите на мощность сервера в BMC: она должна соответствовать паспорту платформы, а нагрузка — распределяться по блокам питания.
NCCL tests: связь между GPU
Высокая скорость отдельных GPU ничего не говорит о связи между ними. Для этого есть nccl-tests — открытый набор тестов NVIDIA для библиотеки NCCL.
- Внутри сервера: all_reduce_perf на всех восьми GPU, с размером сообщений от нескольких байт до нескольких гигабайт (параметры -b, -e, -f и -g 8).
- Смотрите колонку busbw на больших сообщениях и строку Avg bus bandwidth. Сравните с эталоном производителя или с таким же соседним сервером.
- Колонка #wrong должна быть нулевой.
- Для кластера тот же тест запускают на нескольких узлах через MPI. Перед этим ibstat или ibv_devinfo показывают состояние и скорость портов InfiniBand или RoCE, а ib_write_bw из пакета perftest проверяет полосу между узлами.
Для AMD используют rccl-tests с теми же тестами.
Накопители и сеть
- NVMe: nvme list показывает все диски, nvme smart-log — износ, ошибки носителя и наработку. У новых дисков наработка почти нулевая — если нет, это повод для вопросов.
- SATA и SAS: smartctl -a из пакета smartmontools.
- Скорость: fio проверяет чтение и запись на данных, близких к рабочим.
- Сетевые карты: модель и прошивка, скорость линка через ethtool, для InfiniBand — состояние Active.
Что записать в акт приёмки
| Раздел | Что фиксировать |
|---|---|
| Комплектация | Серийный номер шасси, модели и серийные номера GPU, CPU, модулей памяти, дисков, сетевых карт, блоков питания |
| Состояние | Фото упаковки и корпуса, замечания по внешнему виду |
| Прошивки и ПО | Версии BIOS, BMC, VBIOS GPU, прошивок сетевых карт, драйвера и CUDA |
| Диагностика | Уровень dcgmi diag и результат каждого теста |
| Нагрузка | Длительность стресс-теста, максимальные температура и мощность, причины снижения частот |
| Связь | Значения busbw по nccl-tests, статус NVLink и портов сети |
| Журналы | Выгрузка журнала BMC до и после тестов, ошибки Xid и ECC |
| Итог | Дефекты, решение о приёмке, участники, дата, подписи |
Логи всех тестов приложите к акту. Через полгода они помогут доказать, что дефект появился не при приёмке.
Как это связано с проверкой перед отгрузкой
Первая проверка проходит ещё до отгрузки: мы даём доступ к оборудованию на складе поставщика независимому эксперту, которого вы назначите. Он сверяет модель, конфигурацию и серийные номера, а по согласованию проверяет работу под нагрузкой. При запуске на вашей площадке мы проводим стресс-тест и передаём отчёт с логами — его удобно приложить к акту. Подробно — в статье «Как проходит поставка GPU-сервера».
Приёмка на месте закрывает то, что могло случиться в пути: сверка серийных номеров с отчётом показывает, что приехал тот же сервер, а тесты — что он не пострадал при перевозке. Площадку под нагрузку стоит подготовить заранее — по чек-листу для ЦОД.
Коротко
- Осмотр и сверка серийных номеров до подписания документов о доставке.
- Журнал BMC — до тестов и после.
- nvidia-smi: число и модель GPU, ECC, топология NVLink.
- dcgmi diag уровня 3 или 4.
- Многочасовой стресс-тест GPU, CPU и памяти.
- nccl-tests внутри узла и между узлами.
- SMART дисков и скорость сети.
- Всё — в акт с логами.
Готовые конфигурации — в разделе GPU-серверы, например NVIDIA DGX B200 или Dell PowerEdge XE9680 / XE9685L.
Посчитаем под вашу задачу
Пришлите модель, нагрузку и площадку — подберём конфигурацию и назовём цену и срок за один рабочий день.